


Imagination prompting je způsob, jak zadat prompt obrázkovému modelu: místo přesného popisu scény mu hodíte pár evokativních slov a necháte ho zbytek domyslet. Termín vznikl zdola, v komunitě kolem Midjourney a Stable Diffusion, a oficiální definici nemá dodnes.
Nejdál v popisu té praxe došel Jonas Oppenlaender z univerzity v Jyväskylä. Po tříměsíční etnografické studii online komunity vytřídil šest typů modifikátorů promptu: subject terms, image prompts, style modifiers, quality boosters, repeating terms a magic terms. Studie vyšla v časopise Behaviour & Information Technology a cituje ji skoro každý, kdo o promptování obrázků píše s vážnou tváří.
Mechanika za tím není nijak tajemná. Krátké evokativní zadání se v prostoru text encoderu mapuje na široký region a model doplní zbytek z toho, co viděl v trénovacích datech. Dlouhý popis ten region zúží, jenže zaplatíte dvakrát: pozornost se rozředí mezi tokeny a začne selhávat attribute binding. Učebnicový příklad je zadání „červená kostka vedle modré koule“, ze kterého vypadne kostka modrá.
Volbou mezi obojím říkáte, kde chcete stát na ose mezi variabilitou a kontrolou. Je to přesně stejná osa jako CFG scale nebo teplota u jazykového modelu.
Jen ji řídíte slovy místo parametru.
Rozdíl na třech promptech
Tohle je imagination prompting. Čtyři podstatná jména, žádná geometrie, prostor pro model:
ANO
brutalistická kaple v mlze, betonové stíny, ranní světlo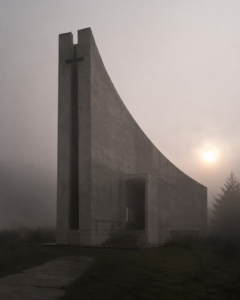
NE
Betonová kaple s plochou střechou, čtvercové okno 2 × 2 m na jižní
stěně, tři schody u vchodu, mlha do výšky jednoho metru, slunce
15° nad horizontem zleva, formát 3:2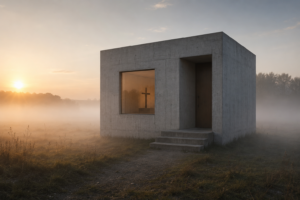
NE
brutalist chapel, 8k, octane render, trending on artstation,
masterpiece, highly detailed, unreal engine 5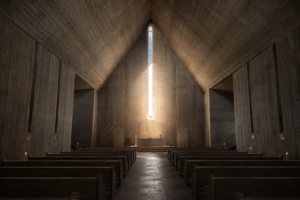
Cargo cult z roku 2022
Poslední příklad si zaslouží vysvětlení, protože ho lidé kopírují dodnes. Keyword salad tohoto typu vznikl jako reakce na CLIP-guided difuzi a Stable Diffusion 1.5, kde byl text encoder slabý a reagoval na statistické asociace s pěknými obrázky v datasetu. Slovo masterpiece nic nepopisovalo. Fungovalo jako ukazatel do lepší části latentního prostoru.
Modely, které kondicionuje T5 nebo rovnou jazykový model, tedy Flux, SD3, Imagen nebo GPT image, rozumějí souvislým větám. Quality boosters u nich obvykle nedělají nic měřitelného a občas výstup dokonce zhorší. Jména umělců navíc z komerčních modelů zmizela kvůli právním sporům, takže část původní Oppenlaenderovy taxonomie ztratila praktický smysl.
Můj argument má jednu díru: u starších lokálních checkpointů, které si spousta lidí pořád ladí na vlastním hardwaru, ty modifikátory měřitelně fungují dál. Mrtvá technika to není. Je vázaná na konkrétní architekturu, jenže tu vazbu skoro nikdo nepojmenovává.
Nejdřív rozhazovat, pak zaostřit
Postup, který se osvědčil, má dvě fáze. Začnete inspiračním promptem s vysokou variabilitou, vygenerujete dvacet obrázků a hledáte kompozici, která sedí. Pak zafixujete seed a přepnete do deskriptivního režimu. Detaily přidáváte po jednom a sledujete, co se rozbije, protože při třech změnách naráz nezjistíte, která z nich to zabila.
Kdo začne rovnou deskriptivně, obvykle stráví hodinu laděním promptu na obrázek, jaký model stejně nedokáže vygenerovat.
Zkuste si to na čemkoli, co máte po ruce. Napište čtyři slova místo čtyřiceti, nechte vyjet dvacet vzorků a podívejte se, co model přinese sám od sebe. Rozptyl výstupů poroste a v tom je celý zisk té techniky. Přesná kopie toho, co jste už měli v hlavě, vás o modelu nic nenaučí.
Proč se to u kódu nechová stejně
Se stejnou logikou se dá jít na jazykový model a je to past. Difuzní model při vágním zadání rozprostře výstupy po širokém okolí, takže z dvaceti vzorků dostanete dvacet různých kaplí. Jazykový model generuje autoregresivně a podspecifikované zadání v něm sklouzne k mediánu. Napíšete „udělej mi autentizaci“ a přijde Express, JWT, bcrypt a struktura, kterou model viděl v trénovacích datech nejčastěji. Podruhé přesně totéž.
Teplota to nespraví. U obrázků znamená vyšší rozptyl víc nápadů, u kódu víc chyb: model si místo odvážnější architektury začne vymýšlet metody, které v knihovně nejsou.
Hlavní rozdíl je ale v ceně vyhodnocení. Dvacet obrázků projdete okem za deset vteřin a vybírá ruka dřív než hlava. Dvacet implementací musíte přečíst a spustit, což trvá dýl než napsat rovnou pořádné zadání.
Přenést se dá jediná věc, zato ta nejužitečnější: fáze rozhozu. Žádejte varianty dřív než kód.
ANO
Navrhni pět různých architektur pro frontu úloh v PHP a MariaDB.
U každé jednu větu, čím se liší, a jednu, kde se rozbije.
Kód zatím nepiš.
NE
Napiš mi něco na fronty úloh, ať je to elegantní a moderní.Druhé zadání vypadá jako imagination prompting, jenže modelu žádný prostor neotevírá. Slova „elegantní“ a „moderní“ nemají v kódu referent, takže se model chytne toho, co je v datech nejčastěji označované jako moderní, a napíše vám React s Tailwindem, i když jste se ptali na frontu.
Rozptyl si u jazykového modelu musíte vyžádat větou, protože sám od sebe nepřijde. Tady končí analogie s kreslením a začíná důvod, proč se návody na promptování obrázků nedají číst jako návody na promptování kódu.



